同一句開頭交給 AI,為什麼有時一直重複,有時卻接出完全不同的故事?這篇使用 Web AI Showcase 的 GPT-2 示範頁,實際切換 Greedy 與 Sample,再只調整 temperature,讓你把設定和生成結果放在同一張比較表裡。
本文寫給想理解取樣設定、但還不想安裝 Python 或串接 API 的讀者。準備桌面瀏覽器、可下載模型的網路,以及一段不含私人資料的英文開頭即可。完成後,你會有四筆設定與輸出紀錄,能區分「有成功生成」和「答案品質比較好」。
DogeLab 於 2026 年 11 月 2 日在 macOS 的 Chrome 完成模型下載、四次生成與圈選截圖;這次畫面顯示的單次生成耗時為 6.85–9.67 秒,不含模型下載。這是單一提示的小型操作實測,沒有做百次品質評測,也沒有驗證中文效果或手機端模型推論。
本文目錄 · 22 個章節
先懂概念:AI 取樣是在選什麼?
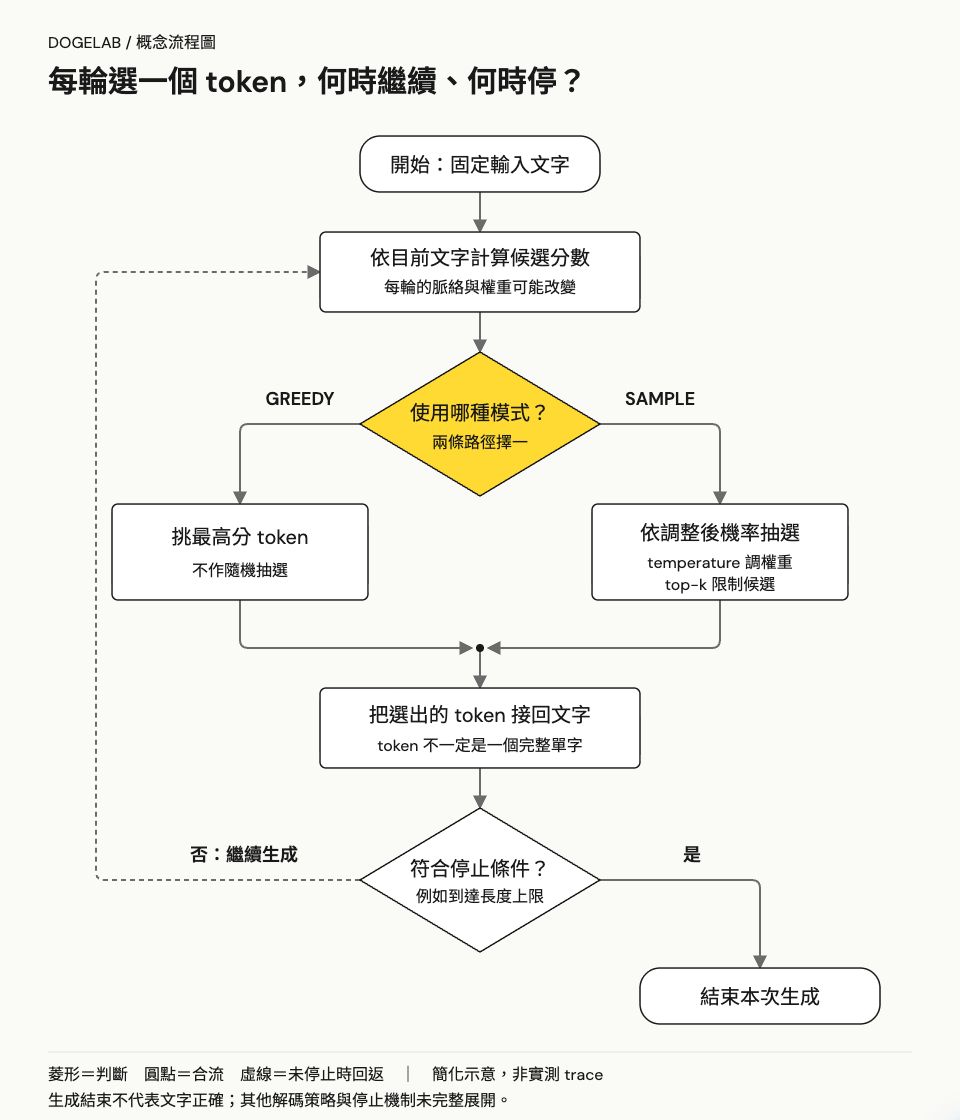
文字生成不是一次挑選整篇答案。以本篇 GPT-2 的續寫為例,模型讀取目前的文字,替可能接上的 token 給分,再由解碼規則選出一個,把它接回文字後繼續。token 是模型處理的文字單位,可能是一個字、詞的一部分或標點,不等於一個完整單字。讀懂這點,才不會把 tokens 40 誤讀為「寫 40 個英文字」。
Greedy(貪婪選擇)在每一輪選當下分數最高的候選;Sample(取樣)則依候選機率抽選。高機率候選較容易被選中,但不代表每次都中選。這些規則決定怎麼接文字,並沒有額外查證事實。Hugging Face 解碼策略文件區分了這兩種選法。
用選午餐理解:最高票與按比例抽籤
假設今天午餐有三個選項,偏好權重是便當 60%、麵食 30%、沙拉 10%。這是人為設定的教學數字,不是本次模型測出的機率。每次直接選最高權重的便當,像 Greedy;按照這三個比例抽籤,像 Sample。抽到沙拉不表示規則失效,也不表示沙拉比較好。
temperature(溫度)改變權重集中程度,不是正確率旋鈕。在簡化情境中,把原始機率視為溫度 1 的基準,溫度改成 0.5,三個權重會先平方再重新正規化:0.36、0.09、0.01 除以總和 0.46,得到約 78.26%、19.57%、2.17%。最高權重更集中,但仍不是必然選便當。這個計算假設沒有加入其他篩選或處罰,不能直接當成本頁 GPT-2 的讀數。
top-k 則限制候選數。在同一個午餐例子中,k=2 表示只留下權重最高的便當與麵食,再重新分配機率;它不是「留下 2%」,也不負責判斷營養。本文工具設定 k=40,表示保留 40 個高分候選 token,不是 40 種完整故事。參數定義可查 Hugging Face 生成設定。
類比的界線在這裡:午餐例子只對應單次選擇。模型每接上一個 token,文字脈絡就改變,下一輪的候選與權重也會重算;不是整篇都從同一袋籤抽。較可能出現的字句也不等於事實,低溫不會替模型補上它不知道的資料。
操作心法:先固定比較條件,再看文字品質
像試咖啡配方,一次只改一個條件。要知道水溫的影響,就不能同時換豆子與研磨度。對應到這篇教學:Prompt、tokens 上限、top-k 固定;先比較模式,再在 Sample 裡調整 temperature。模式與溫度同時改變時,不能把差異全歸因於溫度。
把「流程成功」與「內容可用」分開判斷。咖啡有流出來,不代表味道符合需求;同樣地,Done 只表示生成結束。本文還要看是否重複、不連貫或被長度上限截斷。若題目是事實問答,則必須另有可信答案來源;流暢不構成查核。
保留重跑結果,不只選最好的一次。同一配方仍可能有波動,取樣也有隨機性。本文四次只是展示如何比較,不能估計穩定品質或替模型排名;即使只改一個參數,單次輸出差異仍混有隨機波動。原始輸出與設定一起保存,才有討論依據。
先準備工具與一段固定輸入
開啟 Web AI Showcase 的 GPT-2 頁面,找到 Run it。這是第三方作者提供的公開教學工具,使用 Xenova/gpt2 模型;不是 DogeLab 自有服務,也不是 Hugging Face 官方操作介面。本次開啟時不需要帳號。
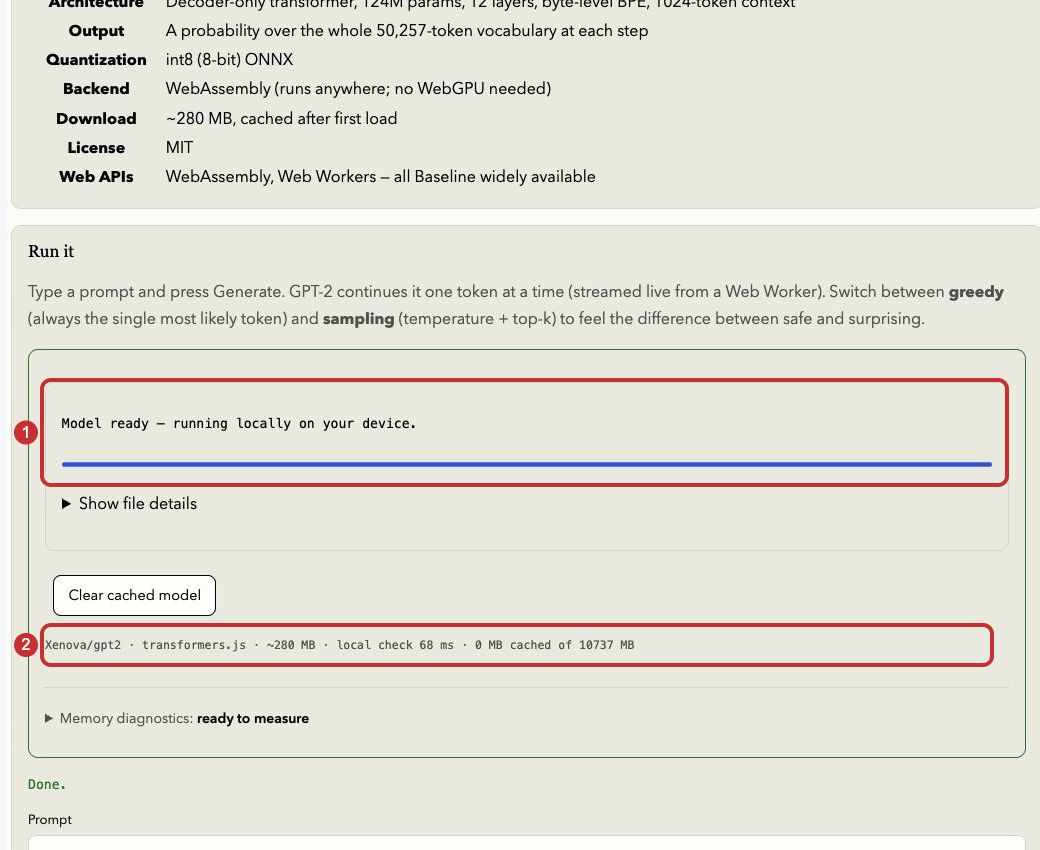
第一次使用會看到 Download model (~280 MB)。按下後等待下載及初始化,直到顯示 Model ready — running locally on your device.。本次確實走過這個流程。下圖圈選的是下載後的就緒狀態;如果你只看到進度條,先不要開始計時比較。
為了只觀察設定差異,四次都使用相同輸入,不換題、不改字。這個模型是文字續寫模型,本文給它一個未完成句子,讓它接下去;不要把它當成已針對對話指令訓練的聊天助理。模型背景可查 Xenova/gpt2 模型頁。
可複製的固定輸入
把這一行貼進 Prompt;四輪都貼在同一個欄位,不沿用上一輪生成的續文:
The robot opened the door and意思是「機器人打開門,然後……」。它是本次的固定測試輸入,不需要加上「請扮演專家」。保留 tokens = 40、top-k = 40;先不要按 unicorns、recipe 等範例按鈕,以免換掉提示。工具顯示模型在本機執行,但本篇沒有稽核整個網站的網路行為,請使用這段公開測試文字。
步驟一:選 Greedy,保存第一筆基準
點選 Greedy,確認 tokens 仍是 40,再按 Generate。畫面會先出現 Generating…,輸出逐步增加;等到 Done. 才抄下完整結果及下方讀數。
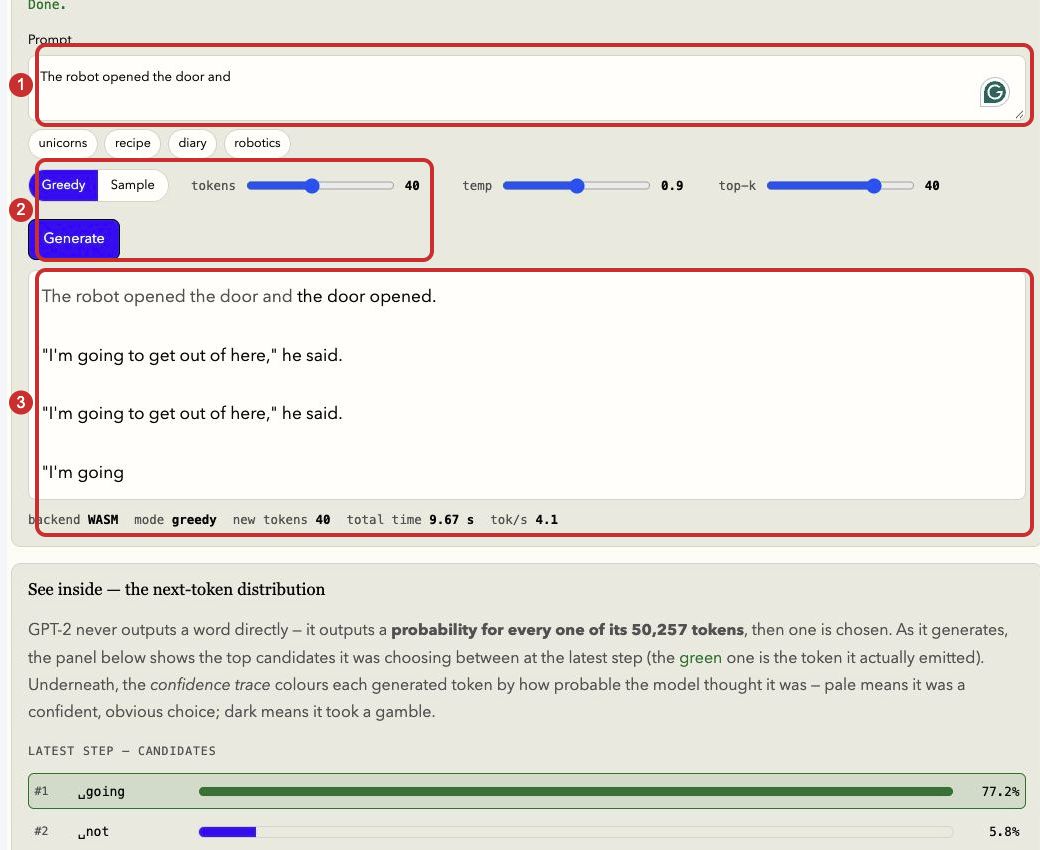
本次新增 40 個 token,頁面計時為 9.67 s。結果先把開頭接成「機器人打開門,門打開了」,接著兩次重複同一句「我要離開這裡」。這一筆可以判定生成流程已跑通,也能直接看到重複;不能因為出現 Done 就判定文字適合發布。
Greedy 每一步選擇最高分候選。雖然頁面仍顯示 temp 0.9,本筆記錄的模式是 greedy;不要把它當作「temperature 0.9 的隨機取樣」。若結果區仍空白,先確認模型就緒及 Generate 沒有停在執行中,不要連續按多次。
步驟二:切換 Sample,其餘設定保留
保留同一句 Prompt、tokens 40、top-k 40,點 Sample。此時確認 temp = 0.9,再按 Generate。等 Done 出現後,核對輸出下方的 mode sample;只有按鈕顏色改變,還不能證明新一輪已執行完成。
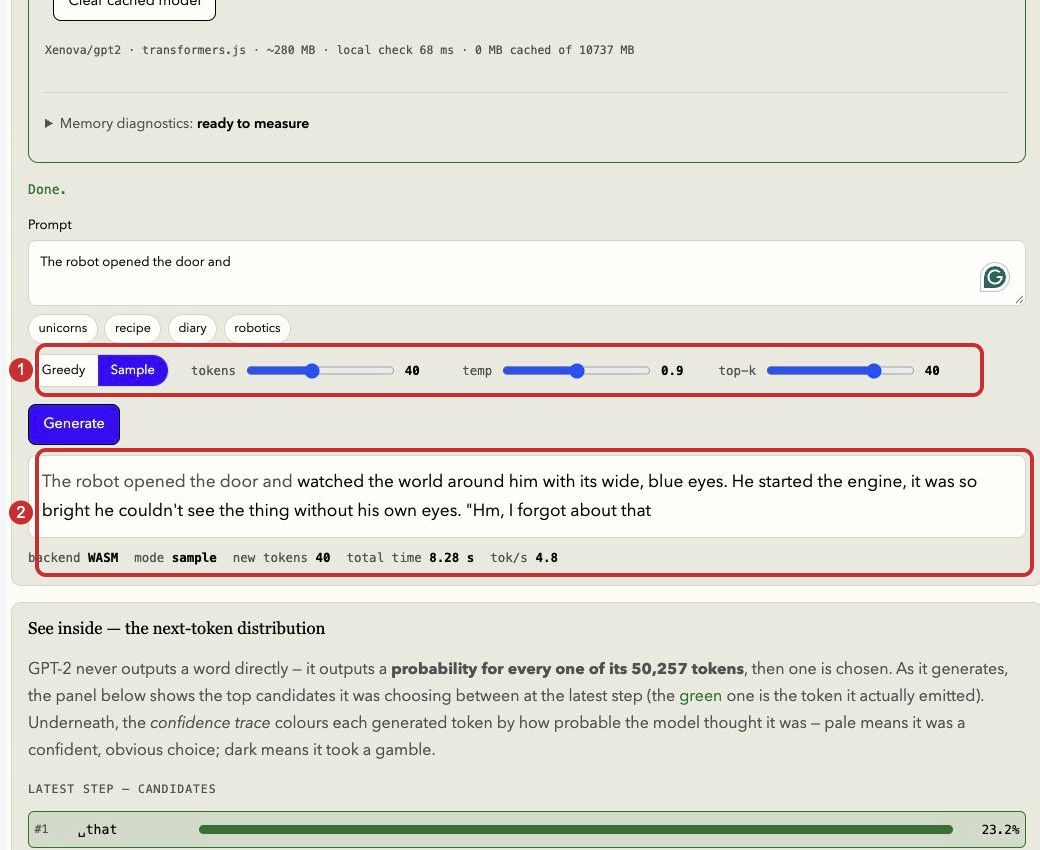
本次新增 40 個 token,計時 8.28 s。續文改成機器人望向周遭世界、啟動引擎的情節,與前一筆不同。這證明我們拿到了另一筆輸出,但這一組同時從 Greedy 換成 Sample,因此不適合單獨歸因為「溫度改變」。接著在 Sample 內只調整溫度。
如果你得到的句子與圖中不同,先核對提示及設定。隨機取樣不保證逐字相同;判定有沒有做對,應看模式、輸入、設定和執行狀態,不是要求複製出同一個故事。
步驟三:只改 temp 到 0.6,再跑一次
保持 Sample,把 temp 滑桿調到 0.6,確認旁邊數字確實顯示 0.6。Prompt、tokens 40、top-k 40 都不改,再按 Generate。
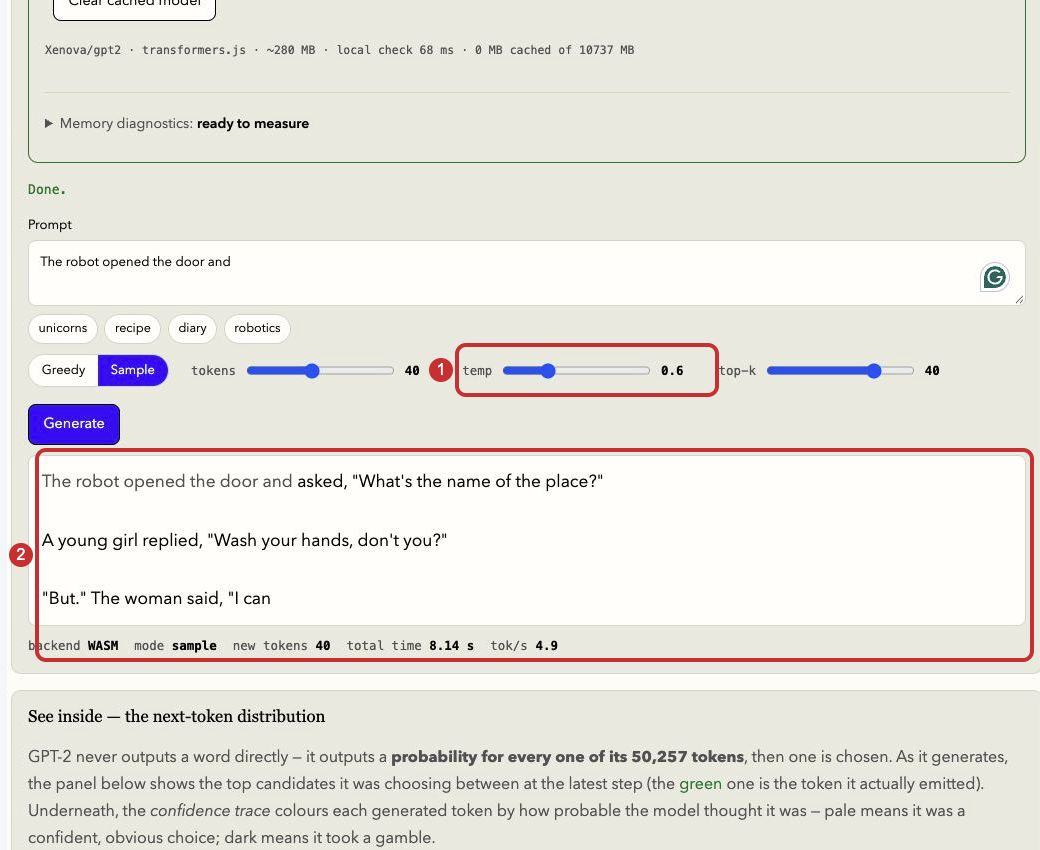
本次計時 8.14 s,同樣新增 40 個 token。內容改成詢問地點名稱、接著女孩回答洗手的片段,前後仍不連貫。降低溫度不會自動賦予模型更好的推理或保證答案正確。
temperature 調整候選 token 的機率分布;top-k 限制保留的高分候選數。此處採用 0.9 與 0.6 是為了示範如何控制變因,不是建議你把所有工具設成這兩個數字。Hugging Face 生成設定文件也區分取樣開關、溫度及候選篩選;實際支援仍以使用中的工具為準。
這個頁面沒有提供 top-p 控制,本篇不宣稱測過 top-p,也不把未顯示的預設值補成已知。
步驟四:設定不動,重跑並填寫比較表
不要改任何欄位,再按一次 Generate。這是第四次生成,與前一次同樣使用 Sample、temp 0.6、top-k 40、tokens 40。
本次計時 6.85 s,又產生 40 個 token,但故事改成一名男子跳進門、機器人離開的情節。相同可見設定得到不同續文,正是我們需要保留多筆原始輸出的原因;不要只留下最漂亮的一次。
| 紀錄 | 模式 | temp | top-k/新增上限 | 實際新增 | 畫面耗時 | 本次觀察 |
|---|---|---|---|---|---|---|
| 1 | Greedy | 不作取樣比較 | 40/40 | 40 tokens | 9.67 s | 同一句對話重複 |
| 2 | Sample | 0.9 | 40/40 | 40 tokens | 8.28 s | 故事情節改變 |
| 3 | Sample | 0.6 | 40/40 | 40 tokens | 8.14 s | 問答前後不連貫 |
| 4 | Sample | 0.6 | 40/40 | 40 tokens | 6.85 s | 同設定重跑,續文再次改變 |
四次都到達設定的 40 token 上限,部分結尾停在句子中間。因此本次完成的是「生成與記錄流程」,不是「產出一段完整可用文案」。若你的任務需要完整段落,另開一輪提高長度上限,再保持所有組別一致,不要只替某組增加長度。
工具沒有提供可設定的 seed;本次也沒有固定模型檔雜湊或底層函式庫版本。可以照本篇重做相同步驟,但不能承諾重現相同字句。上表的幾秒差異亦不能證明某個參數比較快:快取、背景工作和執行順序都沒有控制。
卡住時,先對照這四種情況
| 看到的情況 | 先檢查什麼 | 接著怎麼做 |
|---|---|---|
| Generate 不能按 | 是否已顯示 Model ready | 等待模型就緒;若出現下載錯誤,先檢查連線再重試 |
| 模式切換後像是沒變 | 是否重新 Generate,結果下方 mode 是否更新 | 等 Done 後才記錄,不把上一輪輸出當成新結果 |
| 句子結尾不完整 | new tokens 是否碰到設定上限 | 另開一輪加長上限,所有比較組一起改 |
| 同樣設定卻有不同答案 | 是否為 Sample,提示與其餘設定是否相同 | 保留兩份結果;不要把不同答案直接判為故障 |
工具頁面或模型若更新,請重記日期與可見設定。若入口已不同,不要照舊截圖猜按鈕位置;先重新核對工具說明。
結果驗收:四筆紀錄如何逐項核對
| 預期 | 實際 | 證據 | 未通過時處理 |
|---|---|---|---|
| 模型載入後才能生成 | 本次看到 Model ready | 準備章節的模型就緒圈選圖 | 先等初始化完成,確認網路及下載狀態 |
| 第一筆使用 Greedy | 生成 40 tokens,出現重複對話 | 步驟一圈選圖的 mode 與輸出區 | 核對模式,再按 Generate;不要記錄上一輪結果 |
| 第二筆切換為 Sample 0.9 | 生成 40 tokens,故事改變 | 步驟二圈選圖的 temp、mode 與輸出 | 保持同一句輸入,等 Done 再保存 |
| 第三筆只調低溫度 | Sample 0.6,仍有不連貫內容 | 步驟三圈選圖及本篇比較表 | 核對 top-k 與 tokens 都沒改;不把低溫當品質保證 |
| 第四筆同設定重跑並保存 | 續文再次改變,生成 40 tokens | 本次操作紀錄及上述結果表;本篇未附第四輪圈選圖 | 保存完整原文,不能只挑最好的一次 |
下面是供你保存結果的筆記模板,貼在自己的文字檔,不要貼到 GPT-2 的 Prompt。複製四份,分別填入四輪實際值;中括號由你替換,沒有測到的欄位填「未測」。
紀錄:[1/2/3/4]
日期與瀏覽器:[你的環境]
Prompt:The robot opened the door and
模式:[Greedy 或 Sample]
temp:[Greedy 填不適用;Sample 填顯示值]
top-k:40
tokens 上限:40
完整輸出:[逐字保存,不只寫評語]
實際新增 tokens:[頁面讀數]
頁面耗時:[頁面讀數,非速度排名]
完成狀態:[是否 Done]
證據:[你的截圖檔名]
內容問題:[重複、不連貫、截斷或未見明顯問題]
常見問題 FAQ:開始前與判讀時的八個疑問
1. 沒寫過程式,也能做這個比較嗎?
可以。本篇使用瀏覽器的公開示範介面,不需要安裝 Python 或建立 API 專案。你需要能下載模型的桌面環境,並能保存四筆文字紀錄;本文沒有把手機版文章可閱讀,當成手機能跑模型的證明。
2. 要註冊帳號、買訂閱或準備 API key 嗎?
本次實測沒有要求登入、付費或 API key。這是當時入口的觀察,不是永久免費保證。模型下載與本機運算仍會消耗網路流量和裝置資源;若頁面之後改成需授權或收費,不能沿用本次條件。
3. 可以把英文開頭換成自己的中文問題嗎?
可以另作探索,但本文沒有驗證中文效果,也沒有證明這個續寫模型適合聊天問答。若換題,整組比較都必須用同一份新輸入,並另存紀錄;不要在第二輪才換題,卻把結果差異解釋成參數效果。
4. temperature 越低,答案就越正確嗎?
不是。它調整選擇的集中程度,不會查資料或核對答案。本次 0.6 的輸出仍有不連貫內容;事實正確與否需要另外查核,不能從溫度數字推算。
5. 為什麼 Greedy 模式還看得到 temp 數字?
可見欄位不代表該模式一定使用它。Greedy 的選擇規則是挑最高分候選;本文把該輪記作 Greedy,不把畫面的 0.9 當作隨機取樣條件。核對時看新結果的 mode,而不是只看滑桿位置。
6. 相同設定重跑,是否一定會得到不同文字?
不一定。Sample 可能抽出相同結果,也可能不同;兩次一樣不能證明隨機功能壞了。本次只觀察到一次同設定重跑的續文改變,沒有估計重複機率。工具未提供 seed 控制,也不能承諾逐字重現。
7. 只保存截圖,是否足以比較品質?
最好同時保存完整文字。截圖可核對當時模式和參數;完整輸出便於搜尋、逐句比較與檢查是否截斷。只記「這次比較好」,其他人無法知道你說的是哪一句,也無法覆核。
8. 能用這四次結果決定正式撰稿模型嗎?
不能。它們來自同一模型、單一英文開頭與極少次生成,測的是操作流程。選撰稿模型需要符合實際工作的固定題組、事實基準與獨立評閱;本文的幾秒耗時也不是公平速度排名。
給新手的三個重點
- 參數控制選字,不保證知識正確。Greedy、temperature 與 top-k 解決的是不同的選擇問題,不能用一個數字代替事實查核。
- 公平比較要固定輸入與其他條件。一輪只改一個因素,並保留重跑結果;單次觀察不足以分離參數效果與隨機波動。
- 完成生成與完成作品是兩回事。Done、40 tokens 和幾秒耗時是操作讀數;文字是否連貫、完整、可信,仍需另行判斷。
參考來源
本次資料與操作日期:2026 年 11 月 2 日。以下來源各有不同用途:
- Web AI Showcase:GPT-2 示範頁:本文實際操作入口;頁面可能更新,重做時以當下可見欄位為準。
- Xenova/gpt2 模型頁:核對使用模型及模型檔背景,不代表本文已驗證所有模型用途。
- Hugging Face 生成設定文件:下一階段閱讀取樣與參數定義;本篇只實測頁面上可見的控制項。
原始來源與資料日期
如何測試 LLM 取樣參數?做一份能重跑的設定比較表 · 2026-08-19。發布確認不代表獨立事實查核。